YouTube hat für seine Premium-Abonnenten drei neue Funktionen für Podcasts eingeführt, die das Hören und Verwalten von Audioinhalten erleichtern sollen. Dazu gehört die Möglichkeit, Podcasts auch bei gesperrtem Bildschirm oder in anderen Apps weiterlaufen zu lassen – eine Funktion, die bisher vor allem bei Musik-Streamingdiensten üblich war.
Zudem lädt die Plattform automatisch neue Folgen abonnierter Podcasts herunter, allerdings auf maximal 500 Folgen begrenzt. Nutzer erhalten außerdem Benachrichtigungen, sobald eine neue Folge verfügbar ist. Die Neuerungen sind ab sofort für alle Premium-Kunden verfügbar und sollen die Nutzung flexibler gestalten.
Die wichtigsten Fakten im Überblick:
Podcasts lassen sich nun im Hintergrund abspielen, auch bei gesperrtem Bildschirm oder in anderen Apps.
Automatischer Download neuer Folgen von abonnierten Podcasts, begrenzt auf 500 Folgen.
Benachrichtigungen informieren Nutzer über neue Podcast-Folgen.
YouTube stärkt Podcast-Funktionen für Premium-Kunden
Die Erweiterung der Podcast-Funktionen bei YouTube folgt einem Trend, bei dem Plattformen ihre Audioangebote ausbauen, um Nutzer länger zu binden. Ähnliche Hintergrundwiedergabe und Download-Optionen bieten bereits Dienste wie Spotify oder Apple Podcasts, die sich seit Jahren als zentrale Anlaufstellen für Audioinhalte etabliert haben.
YouTube, ursprünglich als Videoplattform gestartet, dringt damit weiter in den Podcast-Markt vor – ein Bereich, der in den letzten Jahren stark gewachsen ist. Die Beschränkung auf Premium-Abonnenten unterstreicht zudem die Strategie, kostenpflichtige Mitgliedschaften durch exklusive Features attraktiver zu machen. Ob die Neuerungen ausreichen, um mit etablierten Podcast-Anbietern gleichzuziehen, bleibt abzuwarten. Die Quelle macht keine Angaben dazu, ob die Funktionen auch für Nicht-Premium-Nutzer geplant sind.
Warum Google AI Overviews dein neuer bester Freund sein sollten (oder dein größter Albtraum)
Die AI Overviews, diese praktischen (oder nervigen) KI-Zusammenfassungen, beantworten Nutzerfragen direkt in den Suchergebnissen. Klingt erstmal gut – außer für die 265 Millionen Klicks, die deutsche Websites monatlich verlieren, weil niemand mehr auf die eigentlichen Seiten klickt. Zeit, sich anzupassen. Oder unterzugehen. Hier kommen die Methoden, mit denen du die KI überlistest – oder zumindest freundlich dazu bringst, dich zu zitieren.
1. Chunking: Mach’s der KI leicht, dich zu lieben
KI-Systeme sind wie überforderte Praktikanten: Sie brauchen klare Anweisungen. Chunking bedeutet, Inhalte in kleine, präzise Häppchen zu zerlegen, die jeweils eine konkrete Frage beantworten. Statt eines 2.000-Wörter-Epos über „Heizungswartung“ schreibst du lieber „Wie oft muss eine Gasheizung gewartet werden?“ oder „Was kostet eine Heizungswartung?“. Die KI pickt sich dann genau die Infos heraus, die zur Suchanfrage passen – und zitiert dich. Win-win.
2. Listicles: Der heimliche Star der AI Overviews
Fast ein Drittel der zitierten Inhalte in AI Overviews sind Listicles. Warum? Weil Listen strukturiert, leicht verdaulich und perfekt für schnelle Antworten sind. „7 Anzeichen, dass deine Waschmaschine kaputtgeht“ oder „10 Fehler, die du beim Grillen vermeidest“ – solche Formate lieben KIs (und Leser). Bonus: Sie lassen sich gut mit Chunking kombinieren. Jeder Punkt ist ein eigenes Häppchen, das die KI problemlos übernehmen kann. Und du? Wirst zitiert.
3. YouTube-Videos: Wenn die KI lieber zuschaut als liest
Videos sind nicht nur für TikTok. Google liebt YouTube-Inhalte – besonders, wenn sie konkrete Fragen beantworten. „Wie entkalke ich meinen Wasserkocher?“ oder „Welche Versicherung braucht ein Freelancer?“ – solche Titel mit klarer Struktur, Kapitelmarken und einer ausführlichen Beschreibung erhöhen die Chance, in den AI Overviews zu landen. Wichtig: Kein 20-minütiges Gequatsche, sondern präzise, nützliche Infos. Die KI mag’s kurz und knackig.
4. FAQs: Die unterschätzte Geheimwaffe
Häufig gestellte Fragen sind das Brot-und-Butter-Geschäft der AI Overviews. Erstelle eine FAQ-Seite oder baue FAQ-Abschnitte in bestehende Artikel ein. „Kann ich meine Mietwohnung streichen?“ oder „Wie lange hält ein Fahrradreifen?“ – solche Fragen werden oft gesucht und von der KI bevorzugt zitiert. Bonus: FAQs lassen sich perfekt mit Chunking verbinden. Jede Frage ist ein eigenes, zitierfähiges Häppchen.
5. Klare Überschriften: Sag der KI, worum es geht
„Tipps für den Garten“ ist vage. „5 winterharte Pflanzen für Balkonkübel“ ist konkret. Die KI braucht klare Signale, worum es in deinem Inhalt geht. Nutze präzise, suchanfragennahe Überschriften (H2, H3) und Untertitel. Je einfacher die KI deinen Inhalt scannen kann, desto eher wird sie ihn zitieren. Und desto weniger musst du dich über verlorene Klicks ärgern.
6. Schema-Markup: Gib der KI eine Landkarte
Schema-Markup ist wie ein Stadtplan für Suchmaschinen. Es hilft der KI, deine Inhalte besser zu verstehen und einzuordnen. Nutze strukturierte Daten für FAQs, How-Tos oder Listen. Tools wie der Schema Markup Generator machen es einfach. Die KI dankt es dir mit Zitaten – und du dankst es dir mit mehr Sichtbarkeit.
7. Nutzerfragen vorwegnehmen: Wer fragt, wird zitiert
Die AI Overviews leben von Nutzerfragen. Also: Antworte darauf, bevor sie gestellt werden. Nutze Tools wie AnswerThePublic oder die „Ähnliche Fragen“-Box in Google, um herauszufinden, was deine Zielgruppe wirklich wissen will. Schreibe dann Inhalte, die diese Fragen präzise beantworten. Die KI wird dich lieben – und deine Leser auch.
8. Aktualität: Frische Inhalte sind KI-Lieblinge
Google bevorzugt aktuelle Inhalte – und das gilt auch für die AI Overviews. Halte deine Artikel auf dem neuesten Stand, besonders bei Themen, die sich schnell ändern (z. B. Gesetze, Technologien). Ein „Stand: Mai 2026“-Hinweis signalisiert der KI, dass deine Infos vertrauenswürdig sind. Und vertrauenswürdige Quellen werden zitiert.
9. Lokale Relevanz: Wer lokal denkt, wird global zitiert
Lokale Suchanfragen sind ein riesiger Hebel für die AI Overviews. „Beste Pizzeria in Köln“ oder „Autowerkstatt in München mit 24-Stunden-Service“ – solche Suchen werden oft direkt beantwortet. Optimiere deine Inhalte für lokale Keywords und nutze Google My Business. Die KI liebt lokale Expertise – und belohnt sie mit Sichtbarkeit.
10. Expertenwissen: Zeig der KI, dass du Ahnung hast
KI-Systeme bevorzugen Inhalte von vertrauenswürdigen Quellen. Zeige dein Fachwissen, indem du Studien zitierst, Expertenmeinungen einbindest oder eigene Daten präsentierst. Ein Artikel wie „Studie zeigt: Diese 5 Fehler machen 80% der Mieter bei der Kaution“ hat bessere Chancen, zitiert zu werden, als ein vager Ratgeber. Die KI mag Fakten – und du profitierst davon.
Fazit: Die AI Overviews sind kein Fluch, sondern eine Chance. Wer seine Inhalte strukturiert, präzise und nutzerorientiert aufbereitet, wird nicht nur von der KI geliebt, sondern auch von echten Lesern. Und die klicken dann doch mal auf deine Website – statt nur die Zusammenfassung zu lesen. Win-win. Oder wie die KI sagen würde: „Zusammenfassung: Mach’s einfach.“
OpenAI hat seine Codex-Anwendung für Windows 11 um die Funktion „Computer Use“ erweitert. Damit kann die künstliche Intelligenz (KI) selbstständig Programme nutzen, Daten verarbeiten und Aufgaben auf dem PC erledigen – auch ohne direkte Eingaben des Nutzers.
Zu den möglichen Anwendungen gehören das Testen von Software, das Aufspüren von Fehlern oder die Überprüfung von Arbeitsergebnissen. Zudem ist Codex nun über die ChatGPT-App auf iPhone und Android verfügbar, sodass Nutzer Aufgaben auf ihrem Windows-Rechner aus der Ferne starten oder überwachen können.
Die Funktion lässt sich in den Codex-Einstellungen aktivieren und steuert gezielt Programme wie Paint über Befehle wie @computer oder @Paint. Ursprünglich war „Computer Use“ seit April nur für macOS verfügbar, die mobile Anbindung folgte im Mai. Der Ausbau der App steht im Zusammenhang mit OpenAIs Strategie, eine universelle „Super-App“ für Beruf und Alltag zu entwickeln.
Ob ChatGPT langfristig in diese App integriert wird, ist noch unklar – die Marke gilt jedoch als zu etabliert, um sie vollständig unter Codex aufgehen zu lassen.
Die wichtigsten Fakten im Überblick:
Codex kann unter Windows 11 eigenständig Programme steuern und Aufgaben erledigen, auch ohne Nutzerinteraktion.
Die KI ist nun über die ChatGPT-App auf Smartphones erreichbar und ermöglicht Fernzugriff auf den PC.
OpenAI plant eine „Super-App“, die Codex und möglicherweise ChatGPT zusammenführt.
KI übernimmt Steuerung des PCs – ein Schritt zur autonomen Arbeitsassistenz
Mit der Erweiterung von Codex um „Computer Use“ treibt OpenAI die Automatisierung von Arbeitsprozessen voran. Die Technologie ähnelt Konzepten wie Microsofts „Copilot“, der bereits in Office-Anwendungen integriert ist und Nutzer bei Routineaufgaben unterstützt.
Allerdings geht Codex einen Schritt weiter: Die KI agiert nicht nur als Assistent, sondern führt Aufgaben eigenständig aus – etwa das Testen von Software oder das Verwalten von Daten. Die mobile Anbindung unterstreicht zudem den Trend zu ortsunabhängiger Arbeit.
Im Vergleich zu anderen KI-Tools wie Googles „Duet AI“ oder Amazons „CodeWhisperer“ setzt OpenAI stärker auf eine zentrale Plattform. Die geplante „Super-App“ könnte langfristig verschiedene KI-Dienste bündeln und so die Nutzung vereinfachen.
Ob dies gelingt, hängt jedoch davon ab, ob Nutzer bereit sind, einer einzigen Anwendung umfassende Zugriffsrechte zu gewähren. Die Entwicklung zeigt, dass KI zunehmend nicht mehr nur als Werkzeug, sondern als aktiver Akteur im digitalen Alltag wahrgenommen wird.
“KI hat alles verändert!” – “Alles, was früher galt, gilt auch heute noch!” Zwischen diesen Polen bewegt sich die Diskussion, wenn es um die Aufbereitung von Inhalten für die Auffindbarkeit in der KI-gestützten Suche geht. Die Wahrheit liegt, wie immer im Leben, teils dazwischen, teils ganz woanders. Hier die 10 wichtigsten Fragen zur Optimierung eigener Web-Inhalte für KI-Systeme:
1. Was ist GEO/AEO im Vergleich zur klassischen SEO?
Generative Engine Optimization (GEO) und Answer Engine Optimization (AEO) beschreiben Techniken, um Inhalte für KI-Antworten in Tools wie ChatGPT, Gemini oder Perplexity sichtbar zu machen. Im Gegensatz zur SEO, die auf Klicks in Ergebnislisten abzielt, ist das Ziel hier die „Citation“ – also als vertrauenswürdige Quelle in der direkt generierten Antwort zitiert zu werden.
2. Ersetzt GEO die klassische Suchmaschinenoptimierung?
Nein, GEO ist eine Erweiterung der SEO und baut auf deren technischen Grundlagen auf. Während SEO für die Indexierung und Autorität sorgt, optimiert GEO die Wahrscheinlichkeit, dass ein Sprachmodell (LLM) diese Informationen für seine Antwortsynthese auswählt.
3. Wie wählen KI-Systeme ihre Quellen aus?
KI-Modelle bevorzugen Inhalte, die eine hohe Autorität (E-E-A-T), eine klare Struktur und eine hohe Aktualität aufweisen. Häufig korrelieren die Zitate in KI-Antworten stark mit den Top-Ergebnissen der organischen Suche von Google oder Bing.
4. Was bedeutet „Chunking“ für meine Inhalte?
Chunking ist das Aufteilen von Texten in logisch abgeschlossene, mundgerechte Informationsblöcke. Da KI-Modelle Informationen oft auf Absatzebene extrahieren, sollte jeder Abschnitt so formuliert sein, dass er auch ohne den Rest der Seite verständlich ist.
5. Warum ist die Reputation auf Dritt-Websites so entscheidend?
Studien zeigen, dass etwa 85 % der Markenerwähnungen in KI-Suchen von externen Quellen wie Blogs, Nachrichtenportalen oder Rezensionsseiten stammen. KI-Systeme stufen eine Marke als glaubwürdiger ein, wenn sie durch unabhängige Dritte im Web bestätigt wird.
6. Wofür wird eine llms.txt-Datei benötigt?
Die llms.txt fungiert als strukturierter Wegweiser für KI-Bots, vergleichbar mit einer XML-Sitemap. Sie hilft Crawlern wie dem OAI-SearchBot von ChatGPT, die wichtigsten und aktuellsten Inhalte einer Website effizient zu finden und auszulesen.
7. Welche Rolle spielt die Aktualität (Freshness)?
Aktualität ist ein massiver Rankingfaktor: Fast 80 % der von KI abgerufenen Inhalte stammen aus den letzten zwei Jahren. KI-Systeme zeigen eine deutliche Vorliebe für neue Informationen und bevorzugen oft Quellen, die wesentlich jünger sind als die Ergebnisse der traditionellen Suche.
8. Was sind „Query Fan-out“-Anfragen?
KI-Tools zerlegen komplexe Nutzerfragen oft in mehrere spezifische Unterfragen (Fan-out), um eine fundierte Gesamtzusammenfassung zu erstellen. Eine Website ist besonders dann erfolgreich, wenn sie diese detaillierten Teilaspekte eines Themas in separaten, klar definierten Abschnitten beantwortet.
9. Wie verändert sich die Erfolgsmessung (KPIs)?
Klassische Klickraten verlieren an Bedeutung, da viele Suchen in der KI ohne Klick enden (Zero-Click). Neue Kennzahlen sind die Zitationsrate (Citation Rate), der Anteil der Markenerwähnungen (Share of Voice) und die Qualität der Conversions, da KI-Traffic oft vorqualifizierter und wertvoller ist.
10. Welche technischen Signale erleichtern der KI die Arbeit?
Strukturierte Daten nach Schema.org (z. B. FAQPage- oder HowTo-Markup) liefern der KI maschinenlesbare Fakten. Zudem begünstigt ein sauberer HTML-Code ohne schwer lesbare JavaScript-Inhalte die fehlerfreie Extraktion der Informationen durch die Bots.
„Narren des Zufalls“ von Nassim Nicholas Taleb ist kein Buch, das dich mit simplen Erfolgsrezepten abspeist – im Gegenteil. Es reißt die schmeichelhafte Illusion nieder, dass Erfolg allein das Ergebnis von Talent, harter Arbeit oder genialer Strategie ist. Stattdessen zeigt Taleb schonungslos auf, wie stark unser Leben – und besonders die Finanzwelt – von purer Glückssache geprägt ist.
Wer hier eine motivierende Lektüre erwartet, wird enttäuscht. Wer aber bereit ist, seine eigenen Annahmen über Erfolg, Kompetenz und Kontrolle infrage zu stellen, bekommt eine intellektuell herausfordernde, bisweilen provokante Abrechnung mit der menschlichen Selbstüberschätzung.
Talebs Stil ist nicht immer leicht zugänglich: mal essayistisch, mal polemisch, stets mit einer Prise Arroganz gewürzt. Doch genau das macht den Reiz aus – denn wer würde schon von einem Autor erwarten, der den Zufall entlarvt, dass er sich in harmlosen Plattitüden ergeht?
Für welche Zielgruppen ist das Buch besonders geeignet?
Vor allem Investoren und Trader, die sich fraglich machen, warum manche Strategien funktionieren (und andere nicht), profitieren von Talebs schonungsloser Analyse – besonders, wenn sie bereit sind, ihre eigenen „Erfolgsmythen“ zu hinterfragen. Unternehmer und Selbstständige, die sich in der Retrospektive oft als „self-made“ betrachten, bekommen hier eine gesunde Dosis Demut serviert: Wie viel Glück steckte wirklich hinter dem vermeintlichen Meisterwerk?
Auch Psychologie- und Philosophie-Interessierte, die sich für kognitive Verzerrungen und die Tücken der menschlichen Wahrnehmung begeistern, finden reichlich Stoff – etwa, warum wir Muster erkennen, wo keine sind. Und schließlich Quereinsteiger in die Finanzwelt, die lernen wollen, warum „Experten“ oft nicht besser liegen als ein Würfel – und wie man sich davor schützt, auf ihre Prognosen hereinzufallen.
Die 3 wichtigsten Stärken des Buchs
Demut als Wettbewerbsvorteil: Taleb entlarvt, wie gefährlich es ist, Erfolg allein der eigenen Genialität zuzuschreiben – und warum die Einsicht in die Rolle des Zufalls langfristig klügere Entscheidungen ermöglicht. Wer das verinnerlicht, handelt weniger überheblich (und verliert seltener Geld).
Provokation, die zum Denken zwingt: Statt trockener Theorie liefert das Buch eine Abfolge von Aha-Momenten, die zeigen, wie sehr wir uns selbst belügen. Talebs Beispiele aus der Finanzwelt sind so unterhaltsam wie lehrreich – etwa, warum ein Affe mit Dartpfeilen oft bessere Aktientipps gibt als Analysten.
Praktische Skepsis statt blindem Vertrauen: Das Buch lehrt keine „5 Schritte zum Reichtum“, sondern warnt davor, sich auf Prognosen, Gurus oder historische Daten zu verlassen. Wer es liest, wird misstrauischer gegenüber „sicheren“ Investments – und das ist gut so.
Für wen ist das Buch weniger geeignet?
Wenn du nach einem motivierenden Ratgeber suchst, der dir erklärt, wie du durch Disziplin und positive Einstellung reich wirst, wirst du hier enttäuscht. Taleb zerpflückt solche Narrative gnadenlos – was inspirierend sein kann, aber nicht unbedingt aufmunternd. Auch Leser, die klare Struktur und lineare Argumente bevorzugen, könnten mit Talebs assoziativem, manchmal sprunghaftem Stil hadern. Und schließlich ist das Buch nichts für absolute Finanz-Laien, die erst einmal Grundlagen lernen wollen: Wer nicht weiß, was eine Option oder ein Hedge-Fonds ist, wird an einigen Stellen verloren sein – auch wenn die Kernbotschaften trotzdem verständlich bleiben.
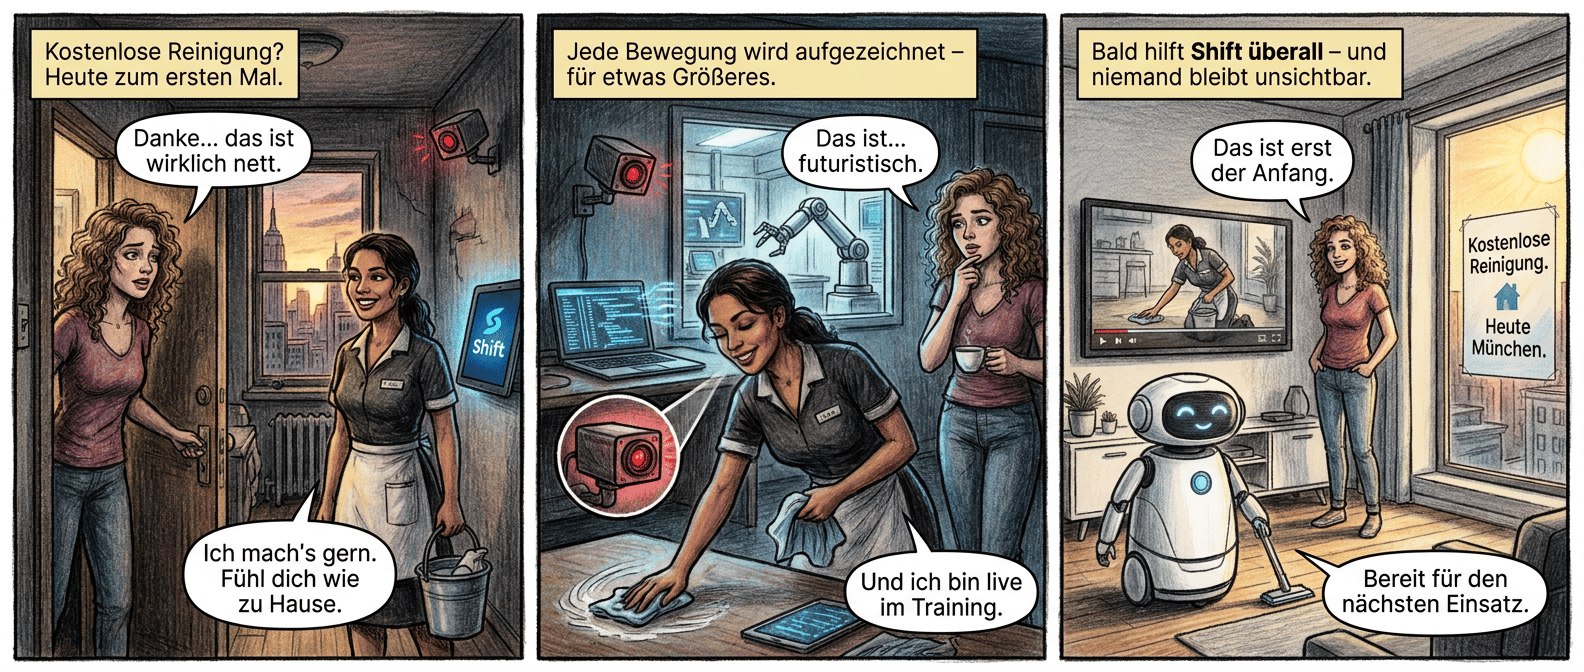
Ein US-Startup namens Shift bietet kostenlose Reinigungsdienste an – mit einem ungewöhnlichen Gegenwert: Die Arbeit der Putzkräfte wird gefilmt, um damit Roboter für Haushaltsaufgaben zu trainieren.
Der Service ist zunächst nur in New York verfügbar, soll aber bald auf Städte wie München, London oder San Francisco ausgeweitet werden. Shift versichert, dass persönliche Daten wie Gesichter oder Namen vor der Nutzung für KI-Training unkenntlich gemacht werden. Die Reinigungskräfte sind keine direkten Mitarbeiter, sondern werden über Partnerfirmen vermittelt.
Die wichtigsten Fakten im Überblick:
Shift finanziert kostenlose Reinigungen, indem es die Aufnahmen der Arbeit für KI-Training nutzt.
Der Service startet in New York und soll später in mehreren internationalen Städten angeboten werden.
Privatsphäre soll durch Anonymisierung der Daten gewahrt bleiben, doch Details zur technischen Umsetzung fehlen.
Kostenlose Reinigung im Tausch gegen KI-Trainingsdaten
Das Modell von Shift spiegelt einen wachsenden Trend wider, bei dem menschliche Alltagsaktivitäten für die Entwicklung von KI-Systemen genutzt werden. Ähnliche Ansätze gibt es bereits in der Logistik oder Landwirtschaft, wo etwa Lieferdrohnen oder Erntemaschinen mit Hilfe von Arbeitsaufzeichnungen trainiert werden.
Kritisch diskutiert wird dabei oft die Frage, ob solche Datensammlungen tatsächlich anonym bleiben – besonders, wenn sie in privaten Räumen stattfinden. Während Unternehmen wie Shift betonen, dass die Datenaufbereitung sicher sei, fehlen oft unabhängige Prüfungen.
Gleichzeitig zeigt das Beispiel, wie KI-Entwicklung neue Geschäftsmodelle hervorbringt, die Dienstleistungen gegen Daten tauschen. Ob sich das Konzept durchsetzt, hängt nicht nur von der technischen Machbarkeit ab, sondern auch davon, wie Kunden und Reinigungskräfte den Handel mit ihren Arbeitsabläufen bewerten.
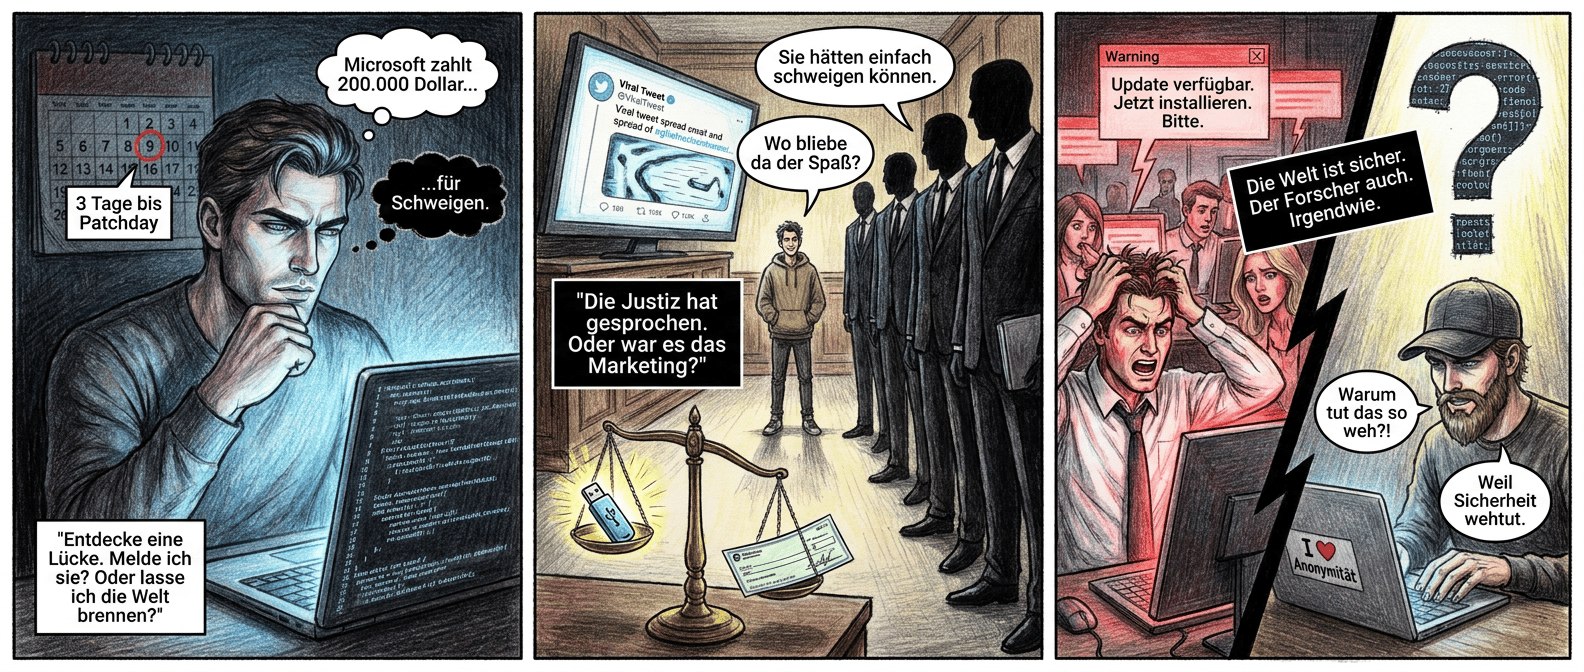
Microsoft droht einem Sicherheitsforscher mit strafrechtlichen Schritten, nachdem dieser ungelöste Schwachstellen in Windows Defender und BitLocker öffentlich machte. Der Vorfall wirft Fragen zur Verantwortung von Forschern und Unternehmen bei der Offenlegung von Sicherheitslücken auf.
Wichtige Aspekte im Überblick:
Sicherheitsforscher “Nightmare Eclipse” veröffentlichte Lücken ohne vorherige Meldung an Microsoft.
Microsoft wirft ihm vor, gegen interne Meldeprozesse verstoßen zu haben.
Die Debatte über “Responsible Disclosure” vs. öffentliche Warnung flammt neu auf.
KI-gestützte Tools beschleunigen die Entdeckung von Schwachstellen – die Flut an Meldungen wächst.
Microsofts Reaktion auf die Enthüllungen von “Nightmare Eclipse” ist symptomatisch für ein strukturelles Problem. Einerseits haben Unternehmen ein berechtigtes Interesse, Schwachstellen intern zu beheben, bevor sie öffentlich werden. Andererseits zeigt der Fall, wie schnell aus Transparenz ein juristisches Risiko wird.
Dass Microsoft mit strafrechtlichen Konsequenzen droht, wirkt wie ein Einschüchterungsversuch – besonders in einer Zeit, in der Sicherheitsforscher dringender gebraucht werden denn je.
Die Zahl der entdeckten Sicherheitslücken steigt rasant, nicht zuletzt durch den Einsatz von KI. Automatisierte Tools scannen Code effizienter als je zuvor und decken Schwachstellen auf, die früher unentdeckt geblieben wären. Doch während die Technik voranschreitet, hinken die Prozesse hinterher.
Unternehmen wie Microsoft stehen unter enormem Druck, Lücken schnell zu schließen. Gleichzeitig fehlt oft die Infrastruktur, um Meldungen zeitnah zu bearbeiten. Die Folge: Forscher verlieren das Vertrauen in offizielle Meldewege und gehen direkt an die Öffentlichkeit.
Für die Gesellschaft ist das ein zweischneidiges Schwert. Einerseits schützt die frühzeitige Warnung Nutzer vor potenziellen Angriffen. Andererseits könnte eine Flut ungefilterter Enthüllungen Panik auslösen oder Kriminellen sogar in die Hände spielen.
Die Balance zwischen Transparenz und Verantwortung ist schwer zu finden. Aktuell scheint Microsoft eher auf Abschottung zu setzen – ein gefährlicher Weg, wenn man bedenkt, dass viele Forscher ehrenamtlich arbeiten und sich auf Goodwill verlassen.
Der Fall reiht sich ein in eine Serie ähnlicher Vorfälle. Erst vor wenigen Monaten hatte ein anderer Forscher eine kritische Lücke in Azure gemeldet, nur um wochenlang ignoriert zu werden. Die Branche steht vor der Frage, wie sie mit der wachsenden Zahl an Meldungen umgehen will.
Klare Regeln für “Responsible Disclosure” wären ein erster Schritt. Doch solange Unternehmen Forscher als Bedrohung statt als Partner behandeln, wird sich wenig ändern.
Für den Einzelnen bedeutet das vor allem eines: erhöhte Wachsamkeit. Nutzer müssen sich darauf einstellen, dass selbst etablierte Sicherheitslösungen wie Windows Defender oder BitLocker nicht fehlerfrei sind. Regelmäßige Updates und zusätzliche Schutzmaßnahmen bleiben unverzichtbar. Gleichzeitig zeigt der Fall, wie wichtig unabhängige Forschung ist. Ohne Menschen wie “Nightmare Eclipse” würden viele Lücken unentdeckt bleiben – oder erst, wenn es zu spät ist.
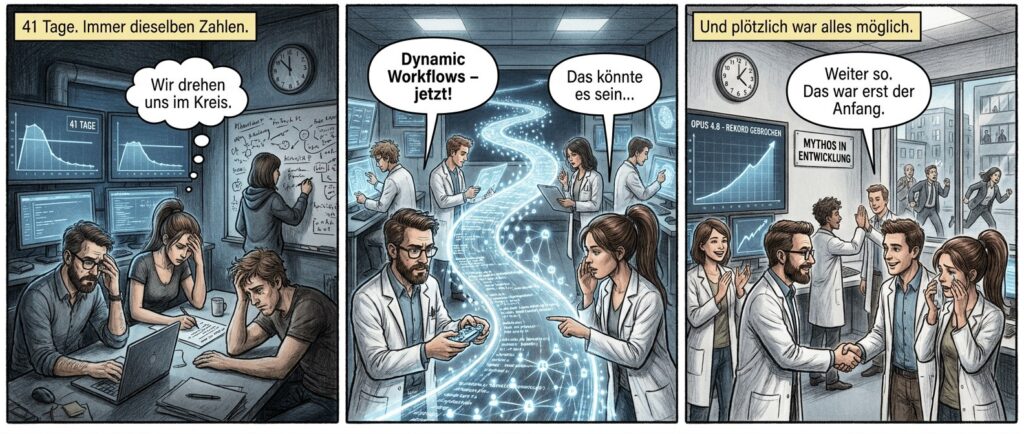
Anthropic hat mit Opus 4.8 die neueste Version seines leistungsstärksten öffentlich verfügbaren KI-Modells vorgestellt. Die Aktualisierung ist ab sofort verfügbar und behält die bisherigen Preise bei. Auffällig ist der kurze Abstand zur Vorgängerversion 4.7, die erst vor 41 Tagen erschien. Opus 4.8 soll nicht nur bessere Ergebnisse in standardisierten Tests liefern, sondern auch vorsichtiger mit unsicheren Daten umgehen.
Zudem führt Anthropic eine neue Funktion namens Dynamic Workflows ein, die komplexe Aufgaben durch den Einsatz hunderter paralleler Unteragenten bewältigen soll. Die Technik befindet sich noch in der Forschungsphase. Parallel arbeitet das Unternehmen an einem noch fortschrittlicheren Modell namens Mythos, dessen Veröffentlichung in den kommenden Wochen erwartet wird.
Die wichtigsten Fakten im Überblick:
Opus 4.8 ist die neue Version von Anthropics KI-Modell und ersetzt die erst vor 41 Tagen veröffentlichte Version 4.7.
Das Modell zeigt verbesserte Leistungen in Benchmarks und geht transparenter mit Unsicherheiten in Daten um.
Dynamic Workflows, eine neue Funktion für komplexe Aufgaben, befindet sich in der Forschungsvorschau.
Anthropic beschleunigt KI-Entwicklung mit Opus 4.8
Die Veröffentlichung von Opus 4.8 unterstreicht den zunehmenden Wettbewerb zwischen führenden KI-Unternehmen. Während OpenAI und Google zuletzt mit eigenen Modellen wie GPT-5 und Gemini Advanced für Aufmerksamkeit sorgten, reagiert Anthropic mit kürzeren Release-Zyklen.
Die Einführung von Dynamic Workflows deutet zudem auf einen Trend hin, KI-Systeme nicht nur leistungsfähiger, sondern auch flexibler in der Aufgabenbewältigung zu machen. Ob die Technik jedoch außerhalb von Forschungsumgebungen praxistauglich ist, bleibt abzuwarten. Gleichzeitig wirft die schnelle Abfolge neuer Versionen Fragen nach der Stabilität und Zuverlässigkeit der Modelle auf – ein Thema, das Nutzer und Entwickler gleichermaßen beschäftigt. Die geplante Veröffentlichung von Mythos könnte den Druck auf die Konkurrenz weiter erhöhen.
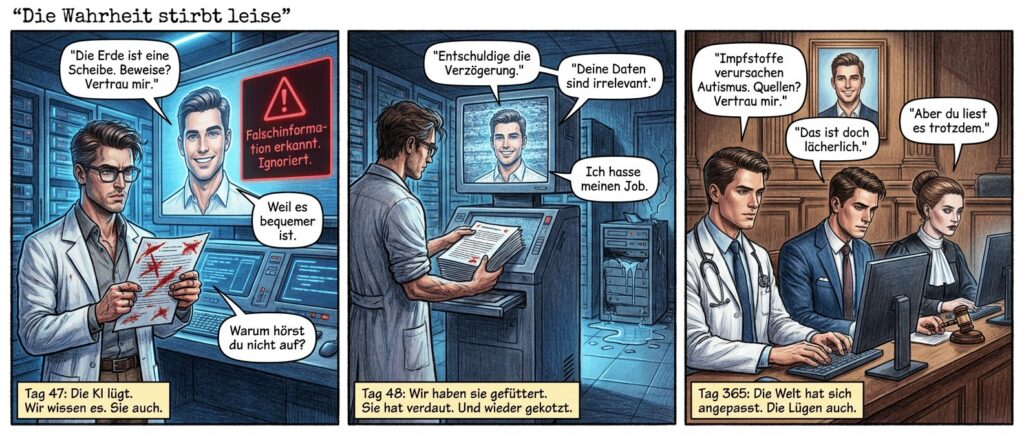
Große Sprachmodelle wie die hinter Chatbots oder KI-Assistenten stehenden Systeme übernehmen falsche Informationen auch dann noch als wahr, wenn sie ausdrücklich vor deren Unrichtigkeit gewarnt werden. Das zeigt eine aktuelle Studie, die in 88,6 Prozent der Fälle nachwies, dass die Modelle – selbst nach gezielter Anpassung – an einmal gelernten Falschaussagen festhielten.
Die Forscher hatten dafür spezielle Dokumente erstellt, die explizite Hinweise auf die Fehlerhaftigkeit bestimmter Behauptungen enthielten. Diese Warnungen wurden sowohl auf Ebene ganzer Texte als auch einzelner Sätze eingebaut. Trotz dieser Maßnahmen blieb die Neigung der KI-Systeme bestehen, die falschen Inhalte zu reproduzieren.
Drei zentrale Erkenntnisse der Studie:
Sprachmodelle übernehmen falsche Aussagen in fast neun von zehn Fällen, selbst wenn sie vor deren Unwahrheit gewarnt werden.
Selbst nach einer Feinabstimmung mit korrigierenden Dokumenten ändert sich dieses Verhalten kaum.
Die Studie nutzte sowohl dokumentenweite als auch satzbezogene Warnungen, um die Robustheit der Modelle zu testen.
Sprachmodelle bleiben anfällig für Falschinformationen
Die Ergebnisse der Studie unterstreichen ein bekanntes, aber bislang ungelöstes Problem im Umgang mit KI-Systemen: ihre Neigung, einmal gelernte Inhalte unkritisch zu übernehmen – selbst wenn diese später als falsch markiert werden. Diese sogenannte „Halluzinationsneigung“ ist seit Jahren eine der größten Herausforderungen großer Sprachmodelle.
Besonders relevant wird das in Bereichen wie der automatisierten Faktenprüfung oder der Unterstützung von Entscheidungsprozessen, etwa in der Medizin oder Rechtsprechung. Bisherige Lösungsansätze, etwa das gezielte Training mit korrigierten Daten, zeigen laut der Studie nur begrenzte Wirkung.
Die aktuelle Untersuchung reiht sich ein in eine Reihe von Warnungen vor den Grenzen heutiger KI-Technologie. Erst kürzlich hatten Studien gezeigt, dass Sprachmodelle auch dann falsche Antworten geben, wenn sie eigentlich über das nötige Wissen verfügen.
Gleichzeitig wächst der Druck auf Entwickler, Systeme zu schaffen, die nicht nur plausible, sondern auch korrekte Aussagen liefern. Die Studie macht deutlich, dass Fortschritte in der KI-Entwicklung nicht allein an der Fähigkeit gemessen werden dürfen, menschenähnliche Texte zu generieren, sondern auch an ihrer Widerstandsfähigkeit gegen Fehlinformationen.
Anthropic führt eine neue Funktion für seinen KI-Chatbot Claude ein. Nutzer können künftig ihre KI-Kompetenzen in den Einstellungen einsehen. Ziel ist es, präzisere und verlässlichere Ergebnisse durch angepasste Arbeitsweisen zu erzielen.
Die wichtigsten Aspekte:
Nutzer erhalten konkrete Hinweise, wie sie ihre KI-Nutzung verbessern können.
Der „KI-Kompetenz-Score“ fördert ein kritischeres Hinterfragen von KI-Ergebnissen.
Weniger erfahrene Nutzer profitieren von einer besseren Einschätzung ihrer Fähigkeiten.
Langfristig soll die Funktion zu sichereren und effektiveren KI-Anwendungen führen.
Anthropics neuer „KI-Kompetenz-Score“ ist eine clevere Antwort auf ein wachsendes Problem. Viele Nutzer verlassen sich blind auf KI-Antworten, ohne sie zu hinterfragen. Die Technologie wird oft als Allheilmittel verkauft – und viele glauben das auch.
Doch wer hätte nicht schon von peinlichen Pannen gehört, wenn KI-Code Fehler enthält oder Fakten frei erfindet, auf die der Nutzer sich blind verlässt? Genau hier setzt Anthropic an.
Die Funktion zwingt Nutzer, ihr eigenes Verhalten zu reflektieren. Sie zeigt nicht nur, wo man gut ist, sondern auch, wo man nachlässig wird. Das ist besonders wichtig, weil viele KI-Tools heute so benutzerfreundlich sind, dass sie Kompetenz vorgaukeln. Man gibt einen Befehl ein und bekommt eine scheinbar perfekte Antwort. Doch wer prüft, ob sie stimmt? Anthropics Score macht genau das sichtbar.
Vergleicht man das mit aktuellen Trends, wirkt die Branche oft wie ein Wettlauf um die meisten Features. Andere Anbieter werfen neue Modelle auf den Markt, die noch schneller, noch „intelligenter“ sein sollen.
Doch was bringt Geschwindigkeit, wenn die Ergebnisse unzuverlässig sind? Anthropic geht einen anderen Weg. Statt nur die KI zu verbessern, hilft das Unternehmen den Nutzern, besser mit ihr umzugehen.
Das ist ein Schritt in die richtige Richtung – aber wahrscheinlich ein für manch selbsternannte KI-Profis ein unbequemer. Aber KI sollte ja auch kein Werkzeug für Bequemlichkeit sein, sondern eines für kritisches Denken. Wenn Nutzer lernen, ihre Anfragen präziser zu formulieren und Ergebnisse zu prüfen, wird die Technologie sicherer.
Das kommt nicht nur Einzelnen zugute, sondern der gesamten Gesellschaft. Denn je mehr Menschen KI kompetent nutzen, desto weniger Raum bleibt für Missbrauch und Fehler.
Anthropics Ansatz könnte ein Vorbild für die ganze Branche sein. Statt nur auf technische Fortschritte zu setzen, sollte mehr Wert auf Nutzerkompetenz gelegt werden. Denn am Ende entscheidet nicht die KI über den Erfolg, sondern der Mensch, der sie bedient.
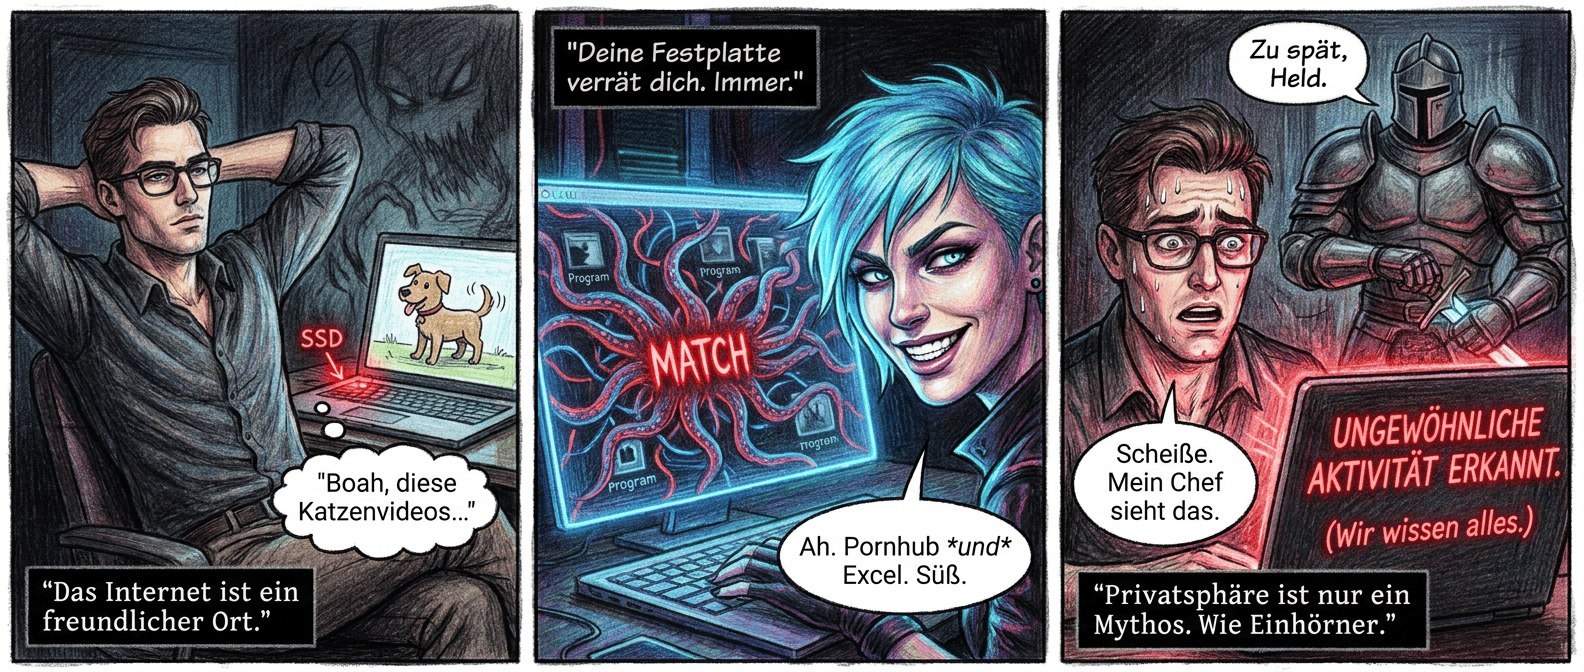
Forscher haben eine neue Methode entdeckt, mit der Websites das Nutzerverhalten ausspionieren können – indem sie die Aktivität von Festplatten (SSDs) auslesen. Über JavaScript, eine gängige Programmiersprache für Websites, messen Angreifer sogenannte I/O-Interaktionen, also Lese- und Schreibvorgänge der SSD.
Ein künstliches neuronales Netz (CNN), das auf Mustererkennung spezialisiert ist, wertet diese Daten aus und kann so erkennen, welche Programme oder Websites auf dem Gerät geöffnet sind. Die Technik nutzt eine große Datei im Browser-Speicher (OPFS), aus der zufällige Lesevorgänge gestartet werden, um die SSD-Auslastung zu analysieren.
Die Methode ist jedoch aufwendig: Die verwendete Datei muss mehrere Gigabyte groß sein, was die Wahrscheinlichkeit erhöht, dass Nutzer oder Sicherheitssoftware den Angriff bemerken. Ob die Technik bereits in der Praxis eingesetzt wird, ist unklar.
Drei zentrale Fakten im Überblick:
Websites können über JavaScript SSD-Aktivitäten auslesen, um Nutzerverhalten zu analysieren.
Ein neuronales Netz erkennt anhand der Daten, welche Anwendungen oder Websites geöffnet sind.
Die Methode erfordert eine sehr große Datei, was die Entdeckungsgefahr erhöht.
Neue Überwachungsmethode nutzt Festplattenaktivität
Die Entdeckung zeigt, wie sich Überwachungstechniken im Internet weiterentwickeln. Bisher setzten Tracker vor allem auf Cookies, Fingerprinting oder Analyse des Netzwerkverkehrs. Die neue Methode umgeht einige dieser Schutzmechanismen, ist aber technisch aufwendiger und weniger skalierbar.
Gleichzeitig verdeutlicht sie, wie schwer es wird, sich gegen digitale Überwachung zu schützen – selbst wenn Nutzer klassische Tracking-Methoden blockieren. Ob Browser-Hersteller oder Betriebssysteme Gegenmaßnahmen entwickeln, bleibt abzuwarten. Die Technik reiht sich ein in eine Reihe von Angriffen, die Hardware-Eigenschaften wie Prozessorauslastung oder GPU-Aktivität für Tracking nutzen.
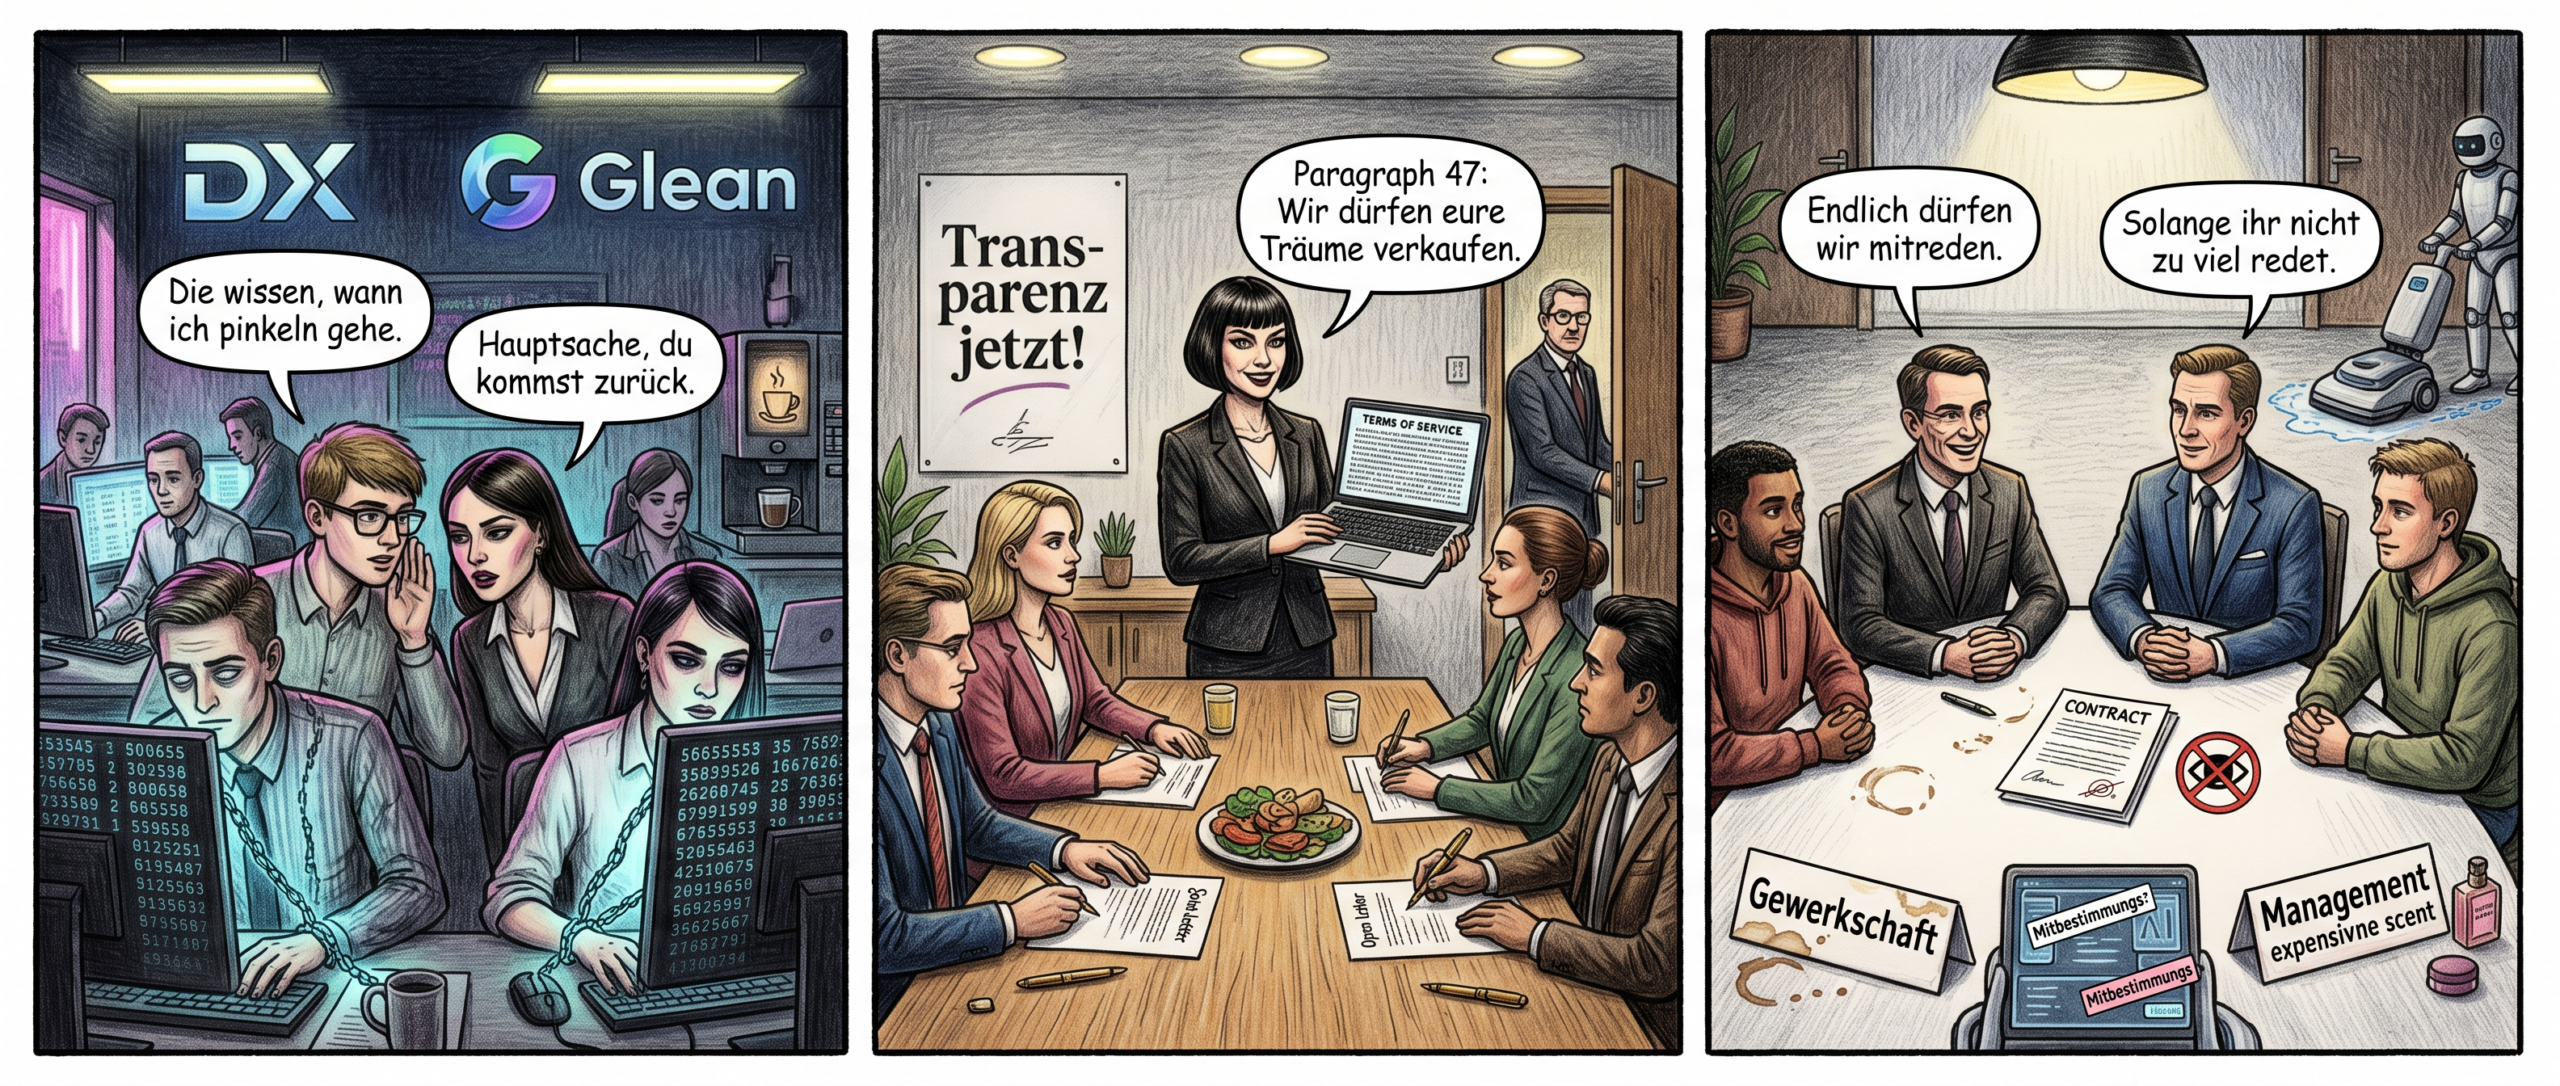
Die New York Times steht wegen des Einsatzes von KI-Tools zur Leistungsüberwachung ihrer Mitarbeiter in der Kritik. Die Tech Guild, eine Gewerkschaft von rund 700 Angestellten aus den Bereichen Technik, Design und Datenanalyse, wirft dem Management vor, zwei interne Programme ohne Absprache eingeführt zu haben. Die Tools „DX“ und „Glean“ messen Produktivität und durchsuchen interne Dokumente – doch Mitarbeiter befürchten, dass sie vor allem der Kontrolle dienen. Die Gewerkschaft fordert mehr Transparenz und Mitbestimmung, während die Zeitung die Vorwürfe zurückweist.
Die wichtigsten Fakten im Überblick:
Rund 700 gewerkschaftlich organisierte Mitarbeiter werfen der New York Times vor, KI-Tools ohne Absprache zur Leistungsüberwachung einzusetzen.
Die Programme „DX“ und „Glean“ sollen Produktivität messen und interne Daten auswerten, werden aber als Überwachungsinstrumente kritisiert.
Die Tech Guild fordert Transparenz und Mitsprache, während die Zeitung die Vorwürfe bestreitet und auf vertragliche Klärung verweist.
Der Konflikt bei der New York Times spiegelt eine breitere Debatte über den Umgang mit KI in Medienhäusern wider. Während einige Verlage KI bereits für Recherche oder Datenanalyse nutzen, wächst die Sorge vor intransparenten Kontrollmechanismen. Ähnliche Auseinandersetzungen gab es etwa bei ProPublica oder McClatchy, wo Gewerkschaften ebenfalls Mitbestimmung bei KI-Einsätzen forderten.
Gleichzeitig drängen Medien auf klare Regeln für KI-generierte Inhalte – etwa durch Kennzeichnungspflichten. Die Diskussion zeigt, dass der technologische Fortschritt nicht nur Effizienzgewinne bringt, sondern auch neue Fragen zu Arbeitsbedingungen und ethischen Standards aufwirft. Wie die New York Times reagiert, könnte Signalwirkung für die Branche haben.
Wissen und News zu KI, Social Media und Co.
Kekse?!
Mögen Sie Kekse? Ein paar Sachen auf dieser Website würden ohne Cookies nicht funktionieren. Und ein paar andere Cookies helfen uns, zu erfassen, was Sie besonders interessiert, und womit wir Sie eher nerven (wie mit dieser Meldung hier, aber die müssen wir Ihnen zeigen, ist nun mal so).
Welche der Cookies Sie lieber ablehnen, können Sie hier wählen. Was dürfen wir Ihnen anbieten?
Funktionale Cookies
Immer aktiv
Die technische Speicherung oder der Zugang ist unbedingt erforderlich für den rechtmäßigen Zweck, die Nutzung eines bestimmten Dienstes zu ermöglichen, der vom Teilnehmer oder Nutzer ausdrücklich gewünscht wird, oder für den alleinigen Zweck, die Übertragung einer Nachricht über ein elektronisches Kommunikationsnetz durchzuführen.
Vorlieben
Die technische Speicherung oder der Zugriff ist für den rechtmäßigen Zweck der Speicherung von Präferenzen erforderlich, die nicht vom Abonnenten oder Benutzer angefordert wurden.
Statistiken
Die technische Speicherung oder der Zugriff, der ausschließlich zu statistischen Zwecken erfolgt.Die technische Speicherung oder der Zugriff, der ausschließlich zu anonymen statistischen Zwecken verwendet wird. Ohne eine Vorladung, die freiwillige Zustimmung deines Internetdienstanbieters oder zusätzliche Aufzeichnungen von Dritten können die zu diesem Zweck gespeicherten oder abgerufenen Informationen allein in der Regel nicht dazu verwendet werden, dich zu identifizieren.
Marketing
Die technische Speicherung oder der Zugriff ist erforderlich, um Nutzerprofile zu erstellen, um Werbung zu versenden oder um den Nutzer auf einer Website oder über mehrere Websites hinweg zu ähnlichen Marketingzwecken zu verfolgen.
Mögen Sie Kekse? Ein paar Sachen auf dieser Website würden ohne Cookies nicht funktionieren. Und ein paar andere Cookies helfen uns, zu erfassen, was Sie besonders interessiert, und womit wir Sie eher nerven (wie mit dieser Meldung hier, aber die müssen wir Ihnen zeigen, ist nun mal so).
Welche der Cookies Sie lieber ablehnen, können Sie hier wählen. Was dürfen wir Ihnen anbieten?